リアルタイム文字起こし
話したその瞬間から、
話したその瞬間から、
テキストがついてくる。
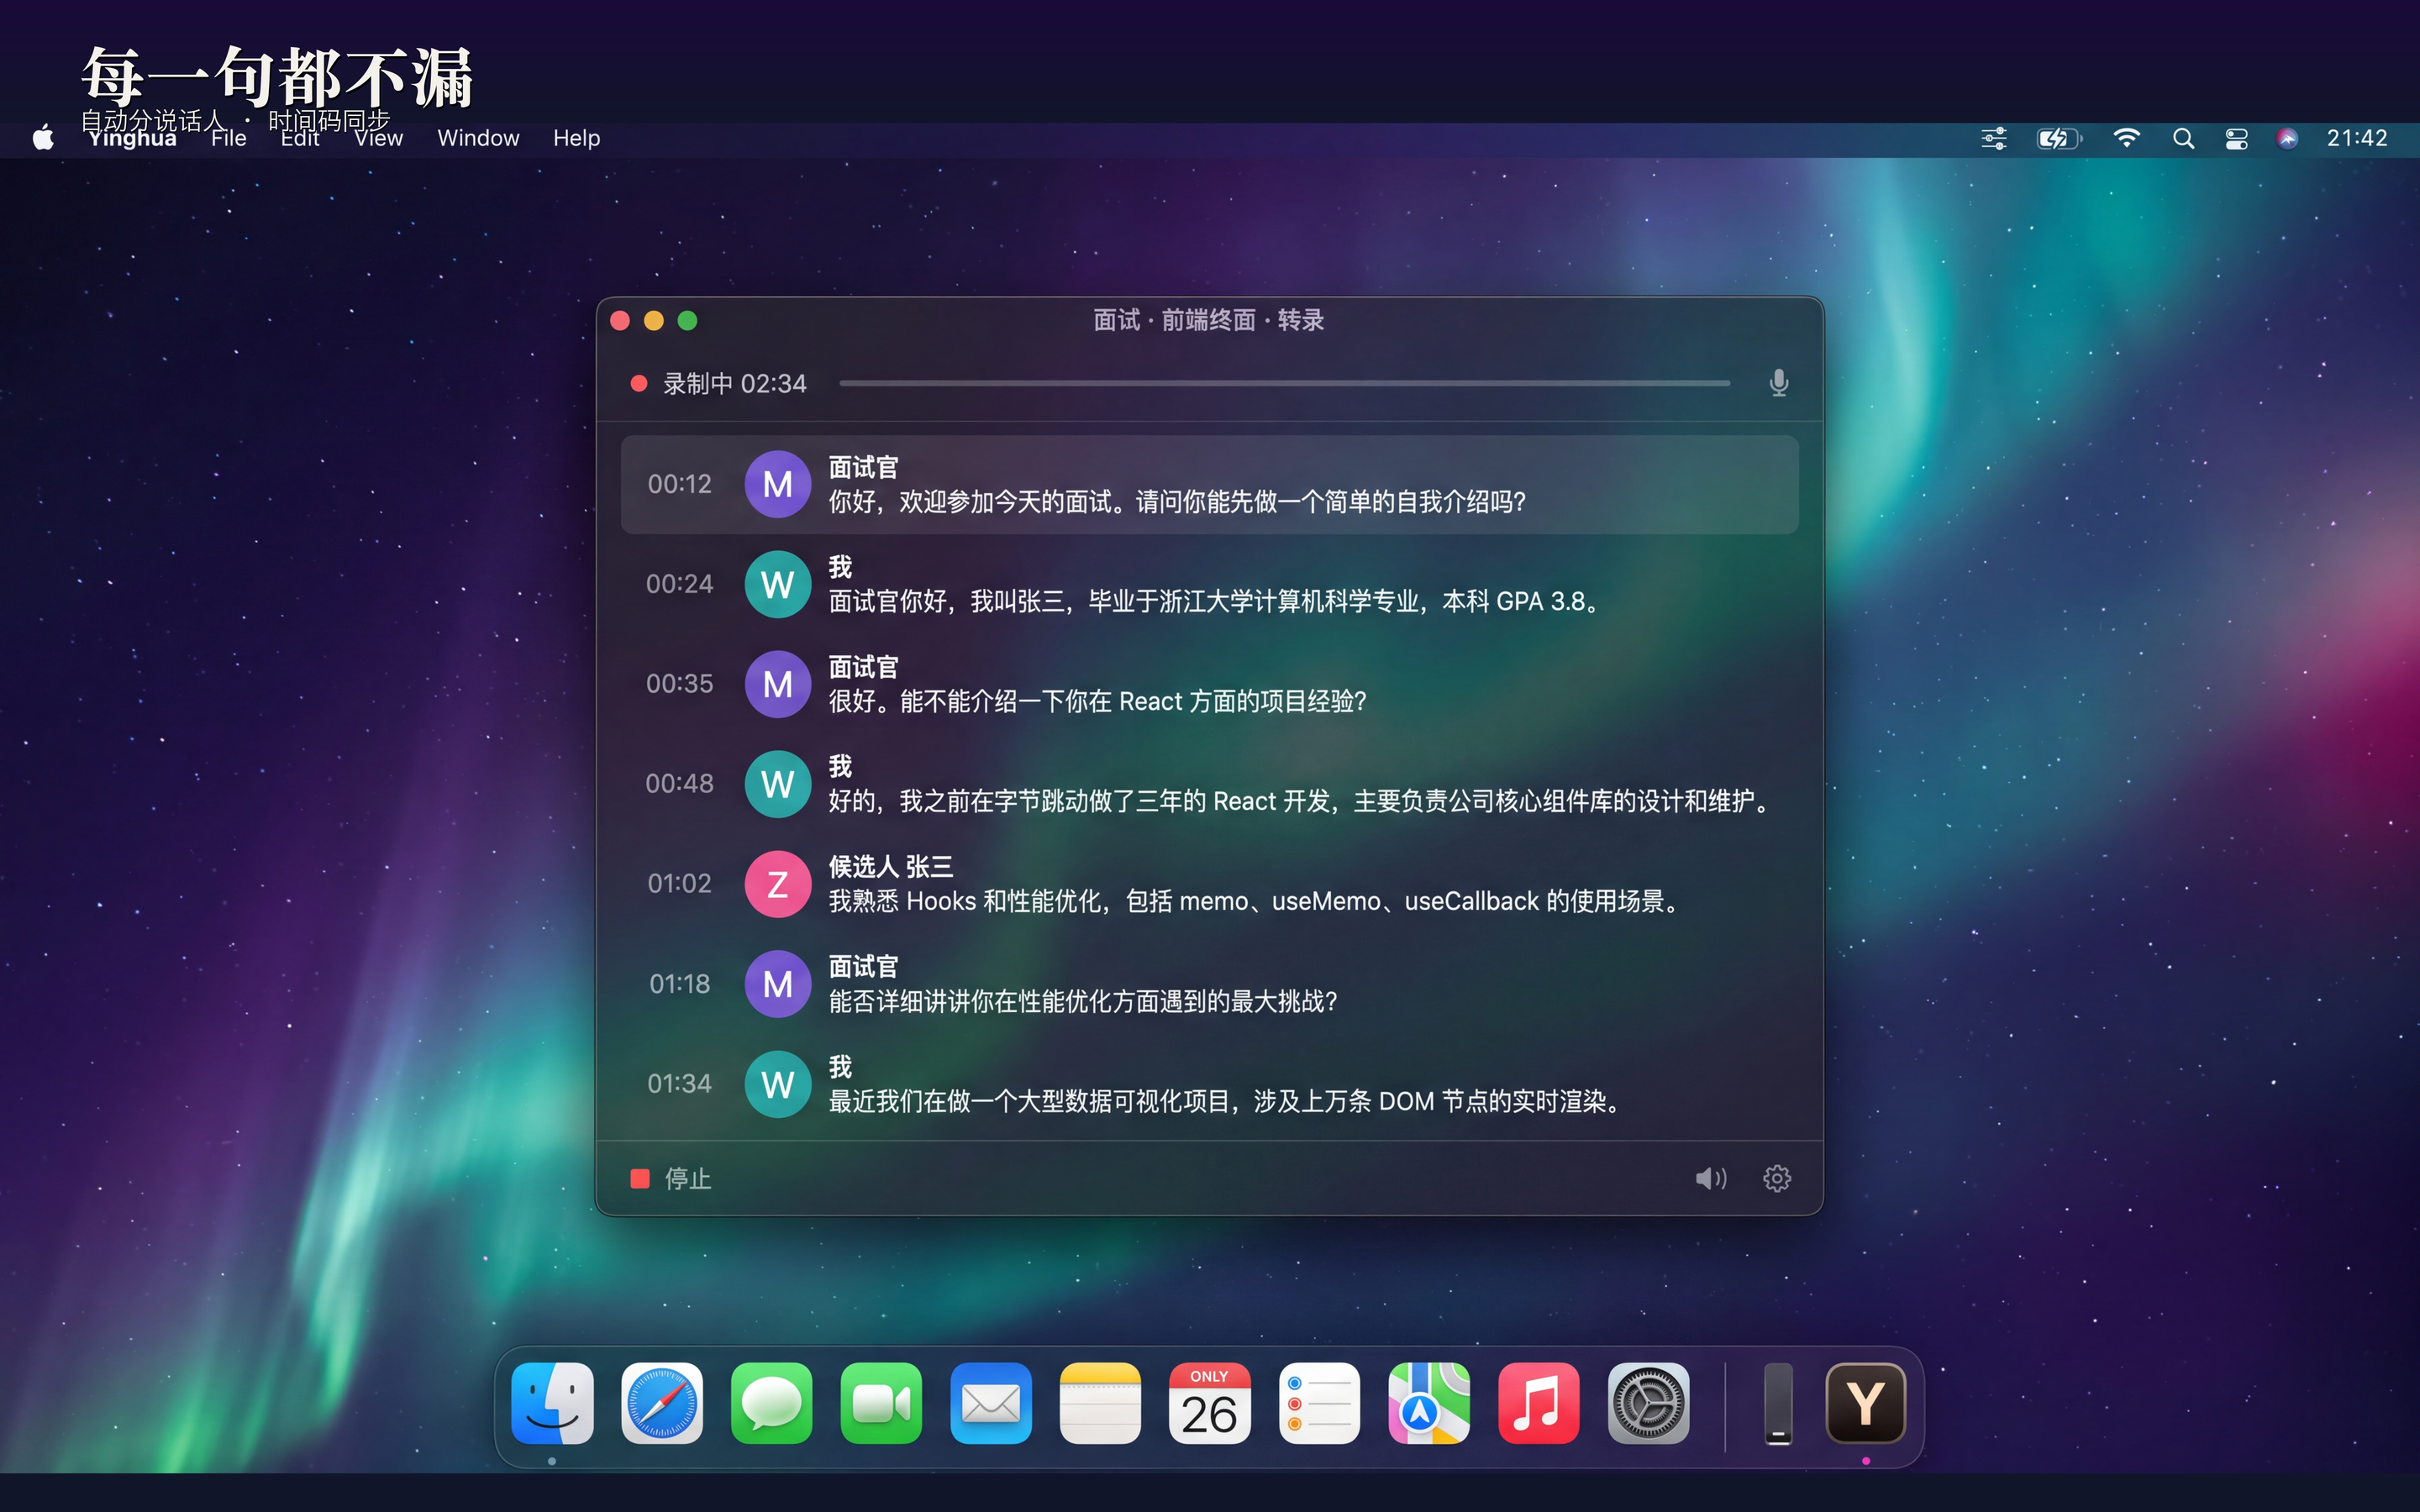
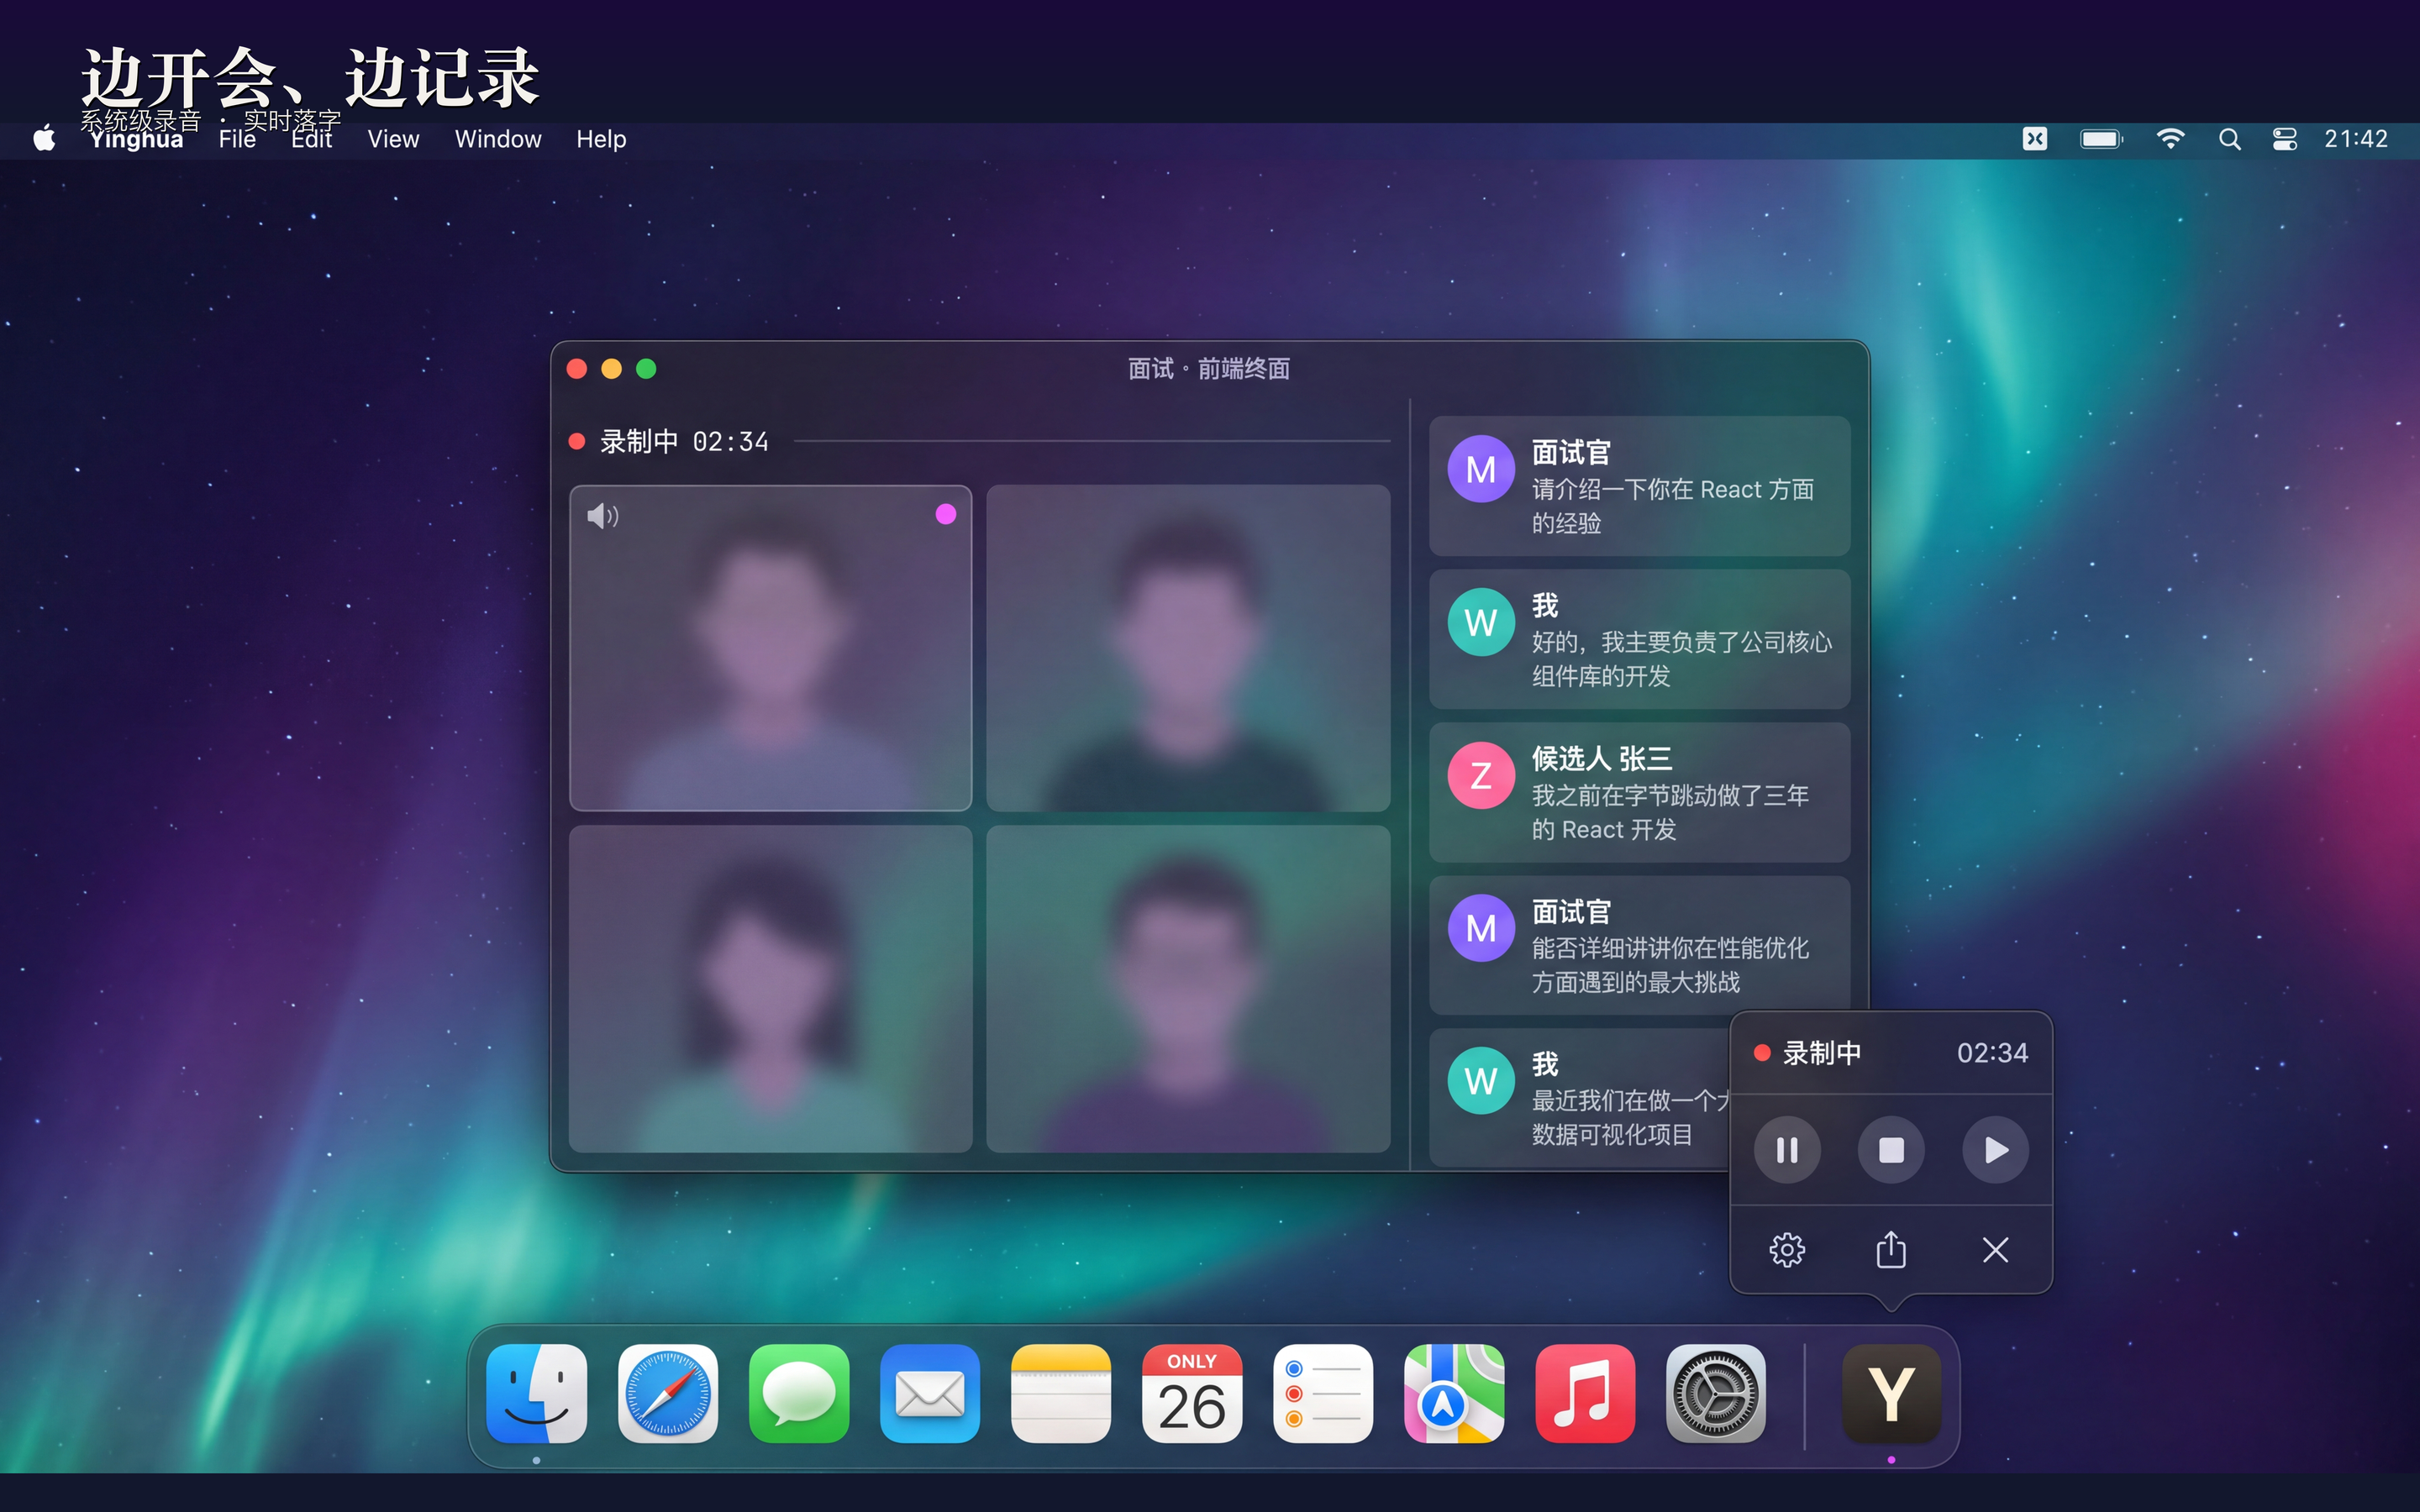
システム音声 + マイクのデュアル録音、ミリ秒レベルの遅延でテキストを出力。話し終われば、テキストも確定します。
- 声紋分離 — 2〜8 名の話者を自動認識し、発言ごとに独立したセグメントに
- 日本語最適化 — Whisper large-v3 日本語モデル + 業界用語カスタム辞書
- オフライン動作 — 録音と文字起こしはすべてローカルで完結、ネットワーク不要
- タイムコードで位置指定 — テキストの任意の行をクリックすると、音声が該当位置にジャンプ